
Vous posez une question à une intelligence artificielle. Quelque part, une bouteille d’eau se viderait aussitôt. L’image est simple, facile à retenir et assez culpabilisante pour être partagée. Mais une requête à l’IA consomme-t-elle vraiment une bouteille d’eau ? Derrière cette formule se trouvent des études, des installations bien réelles… et plusieurs changements de sens en cours de route.
Dans une vidéo publiée sur TikTok le 27 septembre 2026, Numerama remet cette affirmation en question et compare les data centers aux golfs et à l’arrosage des jardins. Nous sommes repartis des chiffres de cet extrait et de leurs références. Résultat : la bouteille par question n’est pas une règle générale, mais certaines comparaisons censées rassurer méritent elles aussi d’être précisées.
Comment une bouteille est devenue une légende numérique
Une référence majeure de cette histoire est le travail de Pengfei Li, Jianyi Yang, Mohammad A. Islam et Shaolei Ren, Making AI Less “Thirsty”, diffusé initialement en 2023. Dans la version consultée, les auteurs estiment qu’avec GPT-3, environ 10 à 50 réponses de longueur moyenne peuvent correspondre à 500 ml d’eau, selon le lieu et le moment du fonctionnement. Il s’agit d’une estimation fondée sur des hypothèses, pas d’un compteur branché sur chaque conversation.
Le glissement apparaît lorsqu’on transforme ce résultat en « une question égale une bouteille », applicable partout et pour toujours. Le modèle, la longueur de la réponse, le matériel, le refroidissement et l’électricité disparaissent de la phrase. Nous ne pouvons pas reconstituer chaque partage de la rumeur, mais le raccourci est identifiable : une estimation située devient une loi universelle.
Avant les chiffres : de quelle eau parle-t-on ?
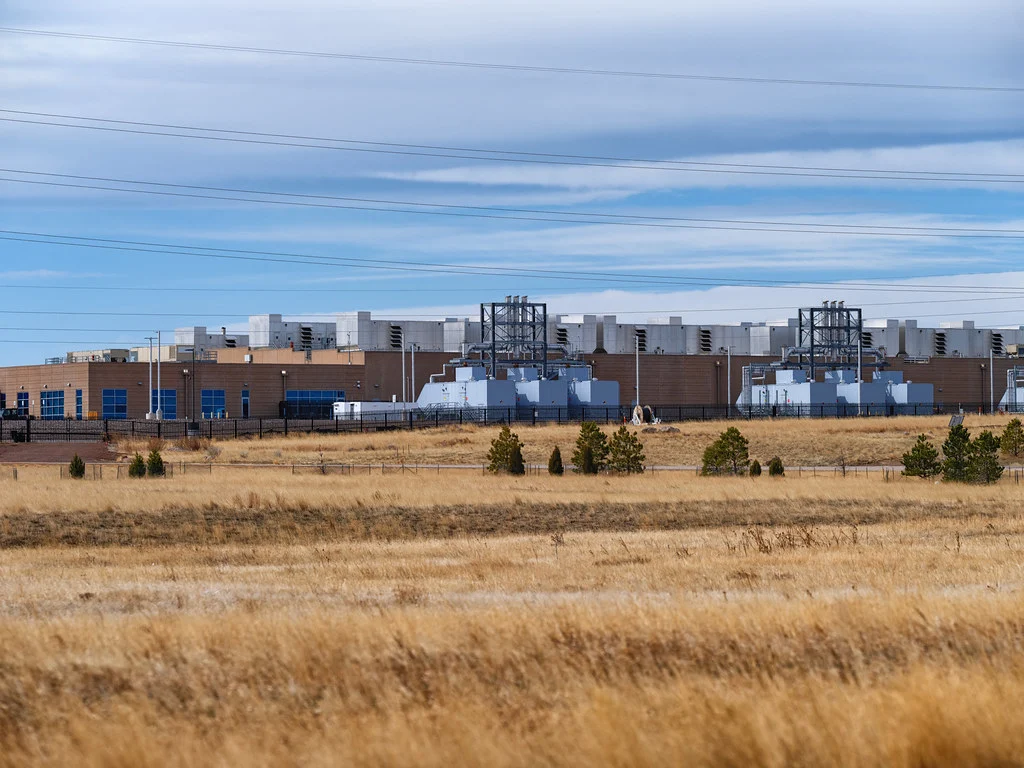
Photo : Tony Webster · CC BY-SA 4.0
Un centre de données rassemble des équipements informatiques qui dégagent de la chaleur. Certains systèmes de refroidissement utilisent l’évaporation de l’eau ; d’autres reposent davantage sur l’air ou des circuits liquides fermés. L’eau peut également intervenir loin des serveurs, lors de la production de leur électricité.
- Prélèvement : eau prise dans une ressource ou un réseau. Une partie peut être rejetée après usage.
- Consommation : part qui n’est pas restituée à la ressource considérée dans la période étudiée, par exemple parce qu’elle s’évapore. Elle ne disparaît pas de la planète pour autant.
- Eau directe ou indirecte : usage sur le site, ou associé notamment à l’électricité et, dans une analyse plus large, à la fabrication du matériel.
Deux volumes exprimés en litres peuvent donc désigner des choses différentes. Et tous les centres de données ne servent pas exclusivement l’IA : ils hébergent aussi des sites, du stockage, des applications et des services d’entreprise. Attribuer leur totalité à une seule technologie serait un autre raccourci.
Les chiffres de la vidéo, remis dans leur contexte
| Chiffre évoqué | Ce qu’il faut retenir |
|---|---|
| 575 000 m³ | Prélèvements directs en 2024 des opérateurs français couverts par l’enquête Arcep. |
| 0,2 % aux États-Unis | Ratio dont la référence mélange consommation estimée et total de prélèvements ; formulation à corriger. |
| 905 millions de gallons | Projection pour les data centers d’Arizona en 2025, soit environ 3,43 milliards de litres. |
| 29 milliards de gallons ; × 32 | Comparaison avec les golfs autour de Phoenix. Division cohérente, année commune non établie dans les références retrouvées. |
| 0,075 % pour Amazon | Comparaison de ses prélèvements mondiaux avec une estimation de l’arrosage résidentiel américain ; pas un bilan complet de l’IA. |
En France, ce que couvrent les 575 000 m³
L’Arcep publie ce chiffre dans son enquête de mai 2026, pour l’année 2024 : 575 000 m³, soit 575 millions de litres, presque entièrement d’eau potable. Attention au champ étudié : 23 opérateurs de colocation et de cohébergement, au-dessus d’un seuil de chiffre d’affaires, exploitant près de 160 centres. Ce n’est pas un inventaire exhaustif de tous les serveurs français.
Le même rapport estime à environ 6,5 millions de m³ le total réunissant les prélèvements directs et la consommation indirecte liée à l’électricité de ce périmètre. Ce total augmente d’environ 8 % en 2024, alors que les prélèvements directs baissent de 15 %. Regarder uniquement le robinet du bâtiment peut donc masquer une évolution différente en amont.
Les « 0,2 % » américains cachent un problème de dénominateur
La vidéo renvoie au Manhattan Institute. Sa tribune renvoie elle-même à un article de Reason comparant environ 625 millions de gallons par jour attribués aux data centers, directement et indirectement, à 322 milliards de gallons par jour pour les États-Unis. La division approche effectivement 0,2 %.
Mais l’USGS décrit ces 322 milliards comme les prélèvements de 2015, eau douce et eau salée réunies. Les prélèvements d’eau douce représentent 281 milliards. Présenter le résultat comme une part de la « consommation d’eau douce » change donc l’indicateur. Les années diffèrent également. Nous ne retenons pas ce ratio comme une mesure homogène de la part nationale des data centers.
Pour situer l’importance de l’indirect, le Lawrence Berkeley National Laboratory estime, pour les centres américains en 2023, environ 66 milliards de litres consommés directement et près de 800 milliards indirectement via l’électricité. Ce sont des estimations de rapport, pas le relevé de tous les compteurs du pays.
Arizona : les golfs consomment-ils 32 fois plus ?
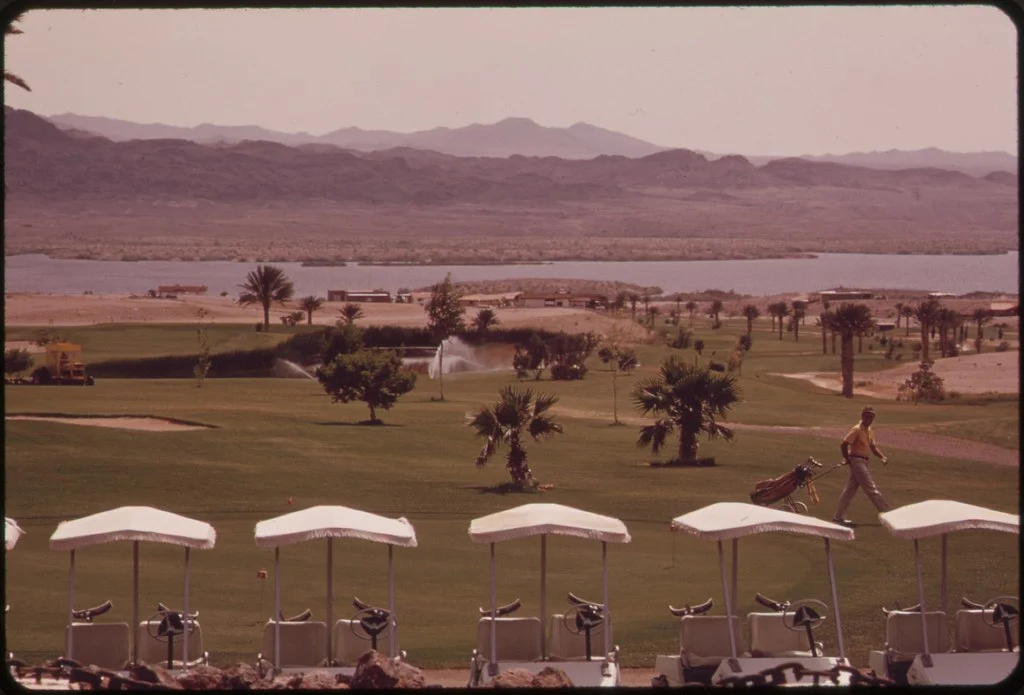
Photo : Charles O’Rear / U.S. National Archives · Aucune restriction de copyright connue
Les 905 millions de gallons remontent à une estimation de Bluefield Research rapportée par Circle of Blue en 2025. La source annonce ce que les data centers d’Arizona devraient consommer cette année-là. Elle ne présente pas un relevé final limité à Google, Microsoft et Meta. Transformer cette projection en consommation définitivement mesurée fait perdre une information importante.
Les 29 milliards pour les golfs figurent dans la chaîne de références du Manhattan Institute, via un billet d’Andy Masley. Nous retrouvons la comparaison, mais pas de quoi confirmer qu’il s’agit de deux relevés complets réalisés la même année. Le calcul 29 milliards ÷ 905 millions ≈ 32 est juste ; cela ne suffit pas à rendre les données parfaitement comparables.
Un golf et un centre de données peuvent aussi puiser dans des ressources différentes. Leur poids relatif dans une région n’indique pas automatiquement la pression exercée sur un réseau précis pendant une période sèche. La comparaison ouvre un débat sur les usages ; elle ne remplace pas l’examen des sites.
Amazon et les pelouses : un calcul juste, un champ limité
Amazon déclare avoir prélevé environ 2,5 milliards de gallons dans ses centres mondiaux en 2025, soit 9,46 milliards de litres. L’entreprise compare ce volume à environ 3 300 milliards de gallons annuels pour les pelouses et jardins américains. On obtient 0,076 % environ, proche des 0,075 % annoncés dans l’extrait.
L’ordre de grandeur de l’arrosage vient d’une fiche de l’EPA : près de 9 milliards de gallons par jour. Il s’agit d’une estimation publiée antérieurement, pas d’une mesure réalisée en 2025 pour cette comparaison. Et le chiffre d’Amazon porte sur ses prélèvements opérationnels : il ne décrit ni l’empreinte complète de sa chaîne d’approvisionnement, ni tous les data centers, ni toutes les IA. La communication de l’entreprise est une source à identifier comme telle.
« L’IA ne sert à rien » : que répondre à cet argument ?
Avant de parler de bière ou de litres d’eau, une objection revient souvent : « Tout cela pour une technologie qui ne sert à rien. » Mais dire que l’IA ne sert à rien parce que certains usages paraissent futiles, c’est un peu comme déclarer Internet inutile parce qu’on y regarde des vidéos de chats. Tout dépend de ce qu’on en fait.
Corriger du code, préparer une traduction, dégager les idées principales d’un dossier, explorer des données, reformuler un courrier ou expliquer un concept : voilà des usages concrets. L’outil peut se tromper et ses réponses demandent une vérification. Mais aider quelqu’un à accomplir une tâche plus rapidement, ou à surmonter une difficulté, constitue déjà une utilité.
Cette utilité ne repose pas seulement sur des témoignages enthousiastes. Dans une étude publiée en 2025 dans le Quarterly Journal of Economics, Erik Brynjolfsson, Danielle Li et Lindsey Raymond ont analysé le déploiement d’un assistant auprès de 5 172 agents de support client. Avec cette assistance, le nombre de problèmes résolus par heure augmente de 15 % en moyenne. Les gains profitent surtout aux agents moins expérimentés. L’assistant propose des réponses ; les salariés restent responsables de la conversation et peuvent modifier ou ignorer ses suggestions.
Le Stanford AI Index 2026 rapporte également des gains d’environ 26 % dans certaines études sur le développement logiciel. Ces résultats concernent des tâches et des conditions précises : ils ne promettent pas 26 % de travail en plus à chaque utilisateur. Le rapport souligne que les bénéfices sont plus nets lorsque le travail est structuré et les résultats faciles à contrôler, et plus limités pour certaines tâches exigeant un raisonnement approfondi.
On peut donc critiquer les erreurs de l’IA, son empreinte environnementale ou certains usages sans lui attribuer une inutilité générale. Des bénéfices sont mesurables ; cela ne rend pas automatiquement chaque utilisation pertinente. La question devient plus concrète : quels usages valent les ressources qu’ils consomment, et existe-t-il une manière moins coûteuse d’obtenir le même résultat ?
C’est à ce stade que la comparaison avec nos habitudes quotidiennes devient intéressante. Une consommation de ressources ne suffit pas, à elle seule, à démontrer l’inutilité d’une activité. Encore faut-il comprendre ce qu’elle apporte et ce que les chiffres comptabilisent réellement. Prenons maintenant un exemple familier : un verre de bière.
Pour remettre les choses en perspective : prenons une bière
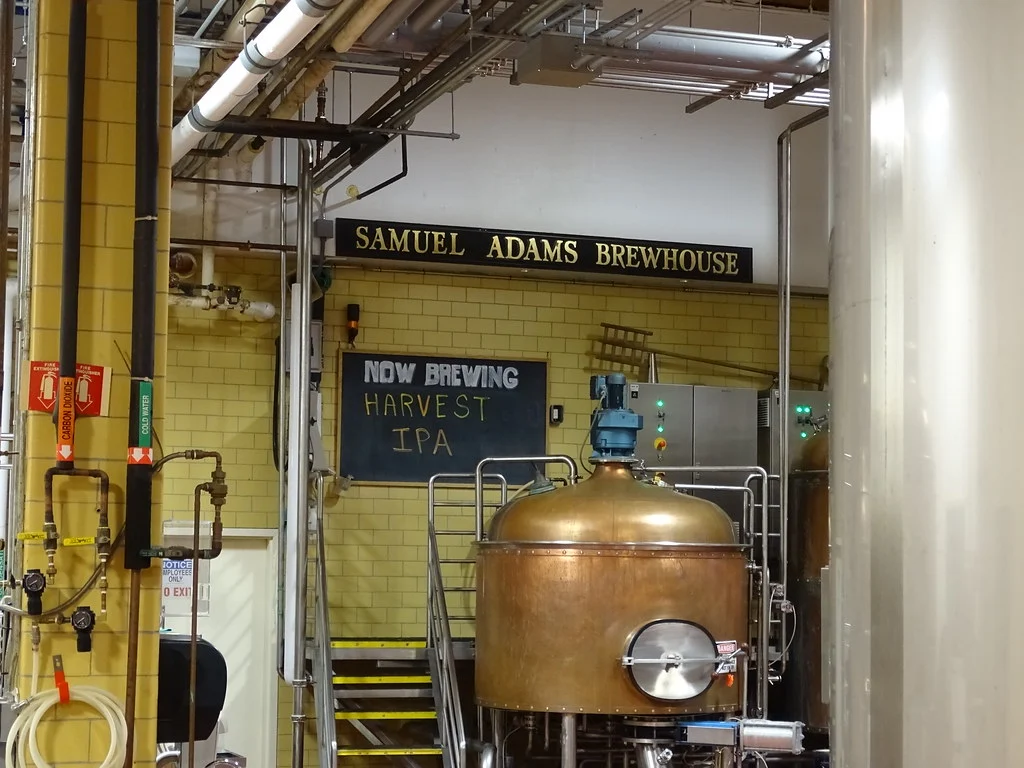
Photo : Adam Jones · CC BY 2.0
Oui, utiliser ChatGPT nécessite des centres de données, de l’électricité et de l’eau, notamment selon les systèmes de refroidissement employés. Mais cela mérite d’être remis en perspective. Prenons une simple bière de 25 cl : son empreinte change beaucoup selon ce que l’on choisit de compter.
Une brasserie compte l’eau qu’elle utilise pour produire, nettoyer et refroidir. Le guide de la Brewers Association évoque un ratio moyen d’environ 7 litres d’eau par litre de bière, avec des établissements performants sous les 3 litres. Une fourchette de 3 à 6 peut correspondre à certaines installations, mais ce n’est pas une constante universelle.
Le Water Footprint Network donne, lui, un ordre de grandeur mondial d’environ 300 litres par litre de bière, qui inclut notamment les cultures en amont. Cela représente environ 75 litres pour un verre de 25 cl. Ce n’est pas une facture de 75 litres d’eau potable au robinet de la brasserie.
Cette méthode distingue l’eau « verte », issue des pluies utilisées par les plantes, l’eau « bleue », provenant des eaux de surface ou souterraines consommées, et l’eau « grise », un volume théorique lié à la dilution des polluants. Additionner ces composantes ne décrit pas seulement de l’eau pompée puis évaporée. Comparer ce total à la seule eau directe d’un serveur donnerait une équivalence trompeuse.
C’est justement ce qui rend cette mise en perspective intéressante. Un chiffre sur l’eau associée à une requête peut vite devenir une accusation : « Chaque fois que vous posez une question à ChatGPT, vous gaspillez de l’eau. » Or, pour une bière, un café, un jean ou un repas comme pour l’IA, constater une empreinte ne suffit pas à qualifier chaque usage de gaspillage. Il faut aussi examiner son utilité, ses alternatives et les conditions locales.
ChatGPT a bien une empreinte environnementale. La question n’est pas de la nier, ni de l’excuser parce qu’un autre produit mobilise lui aussi de l’eau. Mais un chiffre isolé, sans expliquer son périmètre, les conditions de son calcul et ce qu’il mesure réellement, peut donner une vision trompeuse de la réalité.
Avant de conclure qu’une requête à une IA « consomme trop d’eau », encore faut-il savoir quelle eau on compte, comment on la compte et à quoi on la compare. Les 75 litres associés à notre verre de bière éclairent cette différence de périmètre ; ils ne permettent pas de calculer un nombre équivalent de questions à ChatGPT.
Ce que les moyennes nationales ne disent pas
Une faible part nationale et une difficulté locale peuvent coexister. Pour comprendre un projet, il faut connaître la ressource utilisée, les volumes en période chaude, la capacité du réseau et la disponibilité pour les autres usages. Un litre consommé au mauvais endroit et au mauvais moment n’a pas les mêmes conséquences qu’un litre ailleurs.
L’extrait oppose également les usages agricoles à ceux du numérique et des loisirs. Choisir ce qui mérite la ressource relève d’un débat collectif : les chiffres permettent de le préciser, mais ils ne tranchent pas seuls la question de l’utilité. Une empreinte plus faible que celle d’un autre secteur ne devient pas, pour cette seule raison, une empreinte sans conséquences.
Le verdict : non, une question à ChatGPT ne vaut pas systématiquement une bouteille d’eau
L’affirmation « chaque question à ChatGPT consomme une bouteille d’eau » est fausse comme règle générale. L’étude citée dans ce dossier estime environ 500 ml pour 10 à 50 réponses de longueur moyenne avec GPT-3, selon le lieu et le moment de son utilisation. Elle ne dit pas qu’une bouteille entière est consommée à chaque question.
En divisant ces valeurs, on obtient environ 10 à 50 ml par réponse dans les scénarios de cette étude, et non 500 ml à chaque fois. Ce résultat concerne un modèle et des hypothèses précis : ce n’est pas une mesure universelle de ChatGPT aujourd’hui. On ne peut donc pas attribuer un volume fixe à toutes les requêtes, quelles que soient leur longueur et l’infrastructure utilisée.
Utiliser de l’eau ne signifie pas automatiquement la gaspiller. Dans un data center, le refroidissement remplit une fonction : évacuer la chaleur des équipements. Qualifier chaque question de « gaspillage » ajoute un jugement que le seul volume d’eau ne suffit pas à démontrer. Il faut aussi examiner l’utilité de l’usage, l’efficacité du système et la disponibilité locale de la ressource.
Mais l’eau ne fait pas toujours que circuler dans des tuyaux fermés. Une boucle interne peut réutiliser son liquide tandis qu’une tour de refroidissement évapore de l’eau pour évacuer la chaleur à l’extérieur. Cette eau reste dans le cycle de l’eau, mais n’est pas immédiatement rendue à la ressource locale. Dans les tours, les sels se concentrent ; des purges et des traitements contre les dépôts, la corrosion ou les micro-organismes peuvent être nécessaires. Affirmer que l’eau ressort toujours inchangée, « ni salie ni contaminée », serait donc un autre raccourci.
La réponse est donc claire : utiliser une IA a une empreinte hydrique, mais poser une question ne vide pas automatiquement une bouteille d’eau. La légende transforme une estimation variable, portant sur plusieurs réponses, en une consommation fixe par question. C’est cette déformation que les chiffres permettent de réfuter. Les comparaisons avec la bière ou les golfs donnent du contexte ; elles ne sont pas nécessaires pour démonter cette affirmation.
Sources & références
- Numerama — Les data centers ne sont pas les plus gros consommateurs d’eau — TikTok du 27 septembre 2026 ; extrait à l’origine du dossier, étudié à partir de ses sous-titres disponibles.
- Li, Yang, Islam et Ren — Making AI Less “Thirsty” — Travail diffusé initialement en 2023 ; version 5 consultée, estimation de l’empreinte opérationnelle de GPT-3 et conditions de calcul.
- Arcep — Pour un numérique soutenable, édition 2026 — Données 2024 ; champ de l’enquête p. 4 et 17, eau p. 33–35. Les résultats portent sur les opérateurs interrogés.
- Shawn Regan / Manhattan Institute — The Data Center Water Panic Has a Better Answer: Water Markets — Tribune du 24 mars 2026 ; chaîne de références des comparaisons américaines, dont l’article de Christian Britschgi dans Reason et le billet d’Andy Masley. Sources d’argumentation, distinctes des statistiques primaires.
- USGS — Total Water Use in the United States — Définition du total de 322 milliards de gallons par jour : prélèvements de 2015, eaux douce et salée réunies.
- Lawrence Berkeley National Laboratory — 2024 United States Data Center Energy Usage Report — Estimations de consommation d’eau directe et indirecte en 2023, p. 55–57.
- Circle of Blue — Data centers, a small but growing factor in Arizona’s water budget — Reportage de 2025 citant la projection de Bluefield Research pour l’Arizona.
- Amazon — How Amazon is making its data centers more water-efficient — Déclaration de l’entreprise sur ses prélèvements mondiaux de 2025 ; comparaison avec les jardins américains.
- EPA / WaterSense — Reduce Your Outdoor Water Use — Fiche sur les volumes d’eau consacrés à l’arrosage résidentiel aux États-Unis.
- Brewers Association — Water and Wastewater: Treatment/Volume Reduction Manual — Guide professionnel sur les usages directs et l’efficacité hydrique des brasseries.
- Water Footprint Network — Water Footprint Assessment for global sustainability — Exemple d’empreinte moyenne mondiale de la bière. Voir aussi le manuel méthodologique pour les composantes verte, bleue et grise.
- U.S. Department of Energy — Cooling tower management — Fonctionnement des tours de refroidissement : évaporation, recirculation, concentration des minéraux, purges et traitements de l’eau.
- Erik Brynjolfsson, Danielle Li et Lindsey Raymond — Generative AI at Work — Étude publiée en 2025 dans le Quarterly Journal of Economics : 5 172 agents de support client, avec une hausse moyenne de 15 % des problèmes résolus par heure et des effets variables selon l’expérience.
- Stanford HAI — AI Index 2026, chapitre Economy — Synthèse des résultats sur la productivité, dont des gains d’environ 26 % dans certaines études sur le développement logiciel ; limites liées aux tâches et aux conditions d’utilisation.
Auteurs et contributions
Auteurs
 Mathis Cordier